Go-tiny-claw 开发笔记
从零用 Go 实现一个 AI Coding Agent,记录过程中遇到的架构决策、工程细节和踩过的坑。
上下文压缩:类比操作系统内存管理
如何压缩上下文,避免整个 Agent 因上下文窗口限制导致 API 报错而崩溃?可以类比操作系统的内存管理策略。
Compaction(类比 OS 内存压缩 / GC Compact)
- 压缩早期对话,保留决策和结论,丢弃冗余措辞
- 例如:cat 输出 500 行的结果,替换为「返回了 500 行 log,关键错误是 xxx」
- 多层压缩,越早的消息压缩率越高:
raw → summary → meta-summary
Paging / Swap(类比 OS 虚拟内存)
- 每个 session 维护一个 context 目录,将超出窗口的消息转化为 JSON 页文件
- 维护一个索引文件,记录每页的 token 数、时间范围、语义标签
- 提供一个
recall(keyword)工具,按需从磁盘引入相关内容
Priority-based Eviction(类比 OOM Killer)
不是粗暴地 drop 最早的消息,而是给每条上下文打分,在调用前权衡是否需要释放上下文,按优先级进行淘汰:
- System Prompt:永驻
- 最新用户信息:高优先级
- 重复的无用输出:最低优先级
OS 类比:Linux OOM score——不是随机杀进程,而是按 oom_score 选择性终止。
Structured Context Budgeting(类比 cgroups 限额)
为不同 context 分区设置硬上限,防止单块耗尽整个上下文窗口:
| 分区 | 预算 |
|---|---|
| System Prompt | 8k |
| Tools Output | 40k |
| Messages | 40k |
| Scratchpad | 20k |
| Reserved | 20k |
Main Loop:ReAct 引擎
核心循环流程:
初始化 context → 整理 prompt → 发起 API 请求 → 解析模型返回
→ 判断是否 tool_use → 是,执行 tool → 追加观察结果 → 回到整理 prompt 步骤
→ 循环直到完成任务 → 返回纯文本结束
架构进化:Two-Stage ReAct 循环
曾尝试将一次 ReAct 拆成两个阶段:
- 仅传入 Context,不携带 Tool Schema → 强迫 LLM 输出纯文本推理
- 将 Thinking Trace + Tool Schema 拼贴 → 顺着思考思路输出 ToolUse → 执行 → 循环
这个方案现在已经不再是最佳实践,问题如下:
- KV Cache 浪费:每 turn 两次请求,context 重复传一遍,两次 prompt 前缀不同导致 KV cache 经常 miss
- 训练数据不匹配:主流模型训练数据本身就是
thinking → tooluse → toolresult交错的,人为切成两段属于多余 - 幻觉概率增大:第一步可能生成自然语言描述的文件路径,第二轮只能靠猜
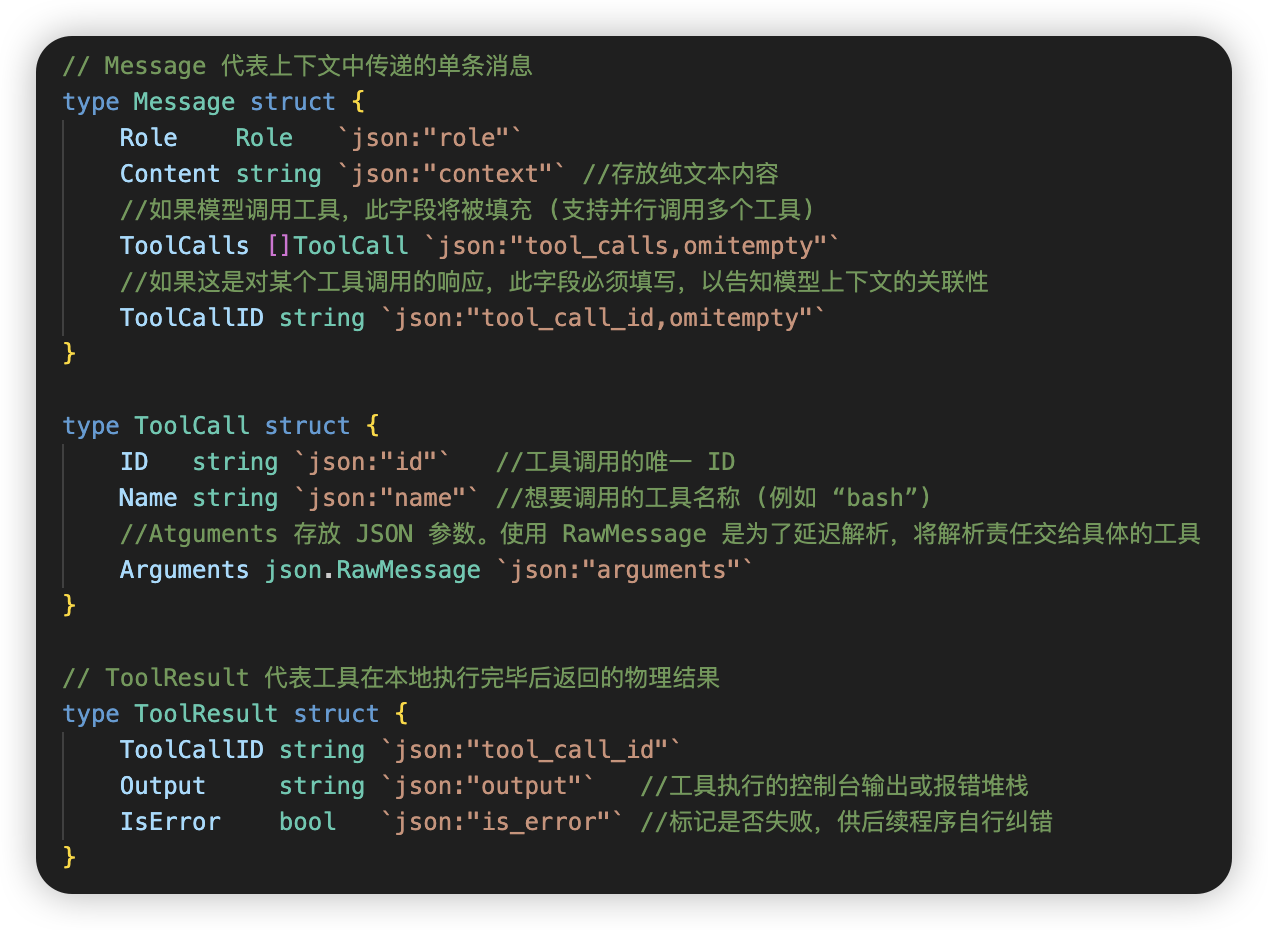
Schema 定义:适配各厂商模型响应
在 schema 中定义明确的数据结构,统一适配各厂商的模型响应格式。
并发调用工具
核心思路
同一轮内的 tool_use 天然独立。LLM 在一个响应里同时发出 read(a) + read(b) + grep("error"),恰恰说明它判定这三个调用互不依赖。如果需要先看 read 结果才知道搜什么,模型会分两轮发。
实现细节
依赖标准库 sync.WaitGroup + 缓冲 channel 当信号量实现。不用 errgroup,避免 fail-fast 把兄弟工具一起取消——单工具失败应让模型自纠正,而不是中断整轮。
- 预分结果切片,长度等于 ToolCalls 数量,每个 goroutine 写自己的下标,天然无锁
- 设置最大并发数:缓冲为 5 的 channel 当令牌池,进入前抢令牌,defer 归还
- 声明 WaitGroup
- 在循环中
wg.Add(1)给 WaitGroup 计数器 +1,并传入下标和 toolcall(注意闭包陷阱) - 唤起 goroutine,
defer wg.Done()在退出前给计数器 -1 sem <- struct{}{}/defer func() { <-sem }():缓冲 channel 当信号量,限制 5 个协程并发(struct{}零字节,不分配内存)- goroutine 执行 tooluse:runWithLock 拿路径锁 → 执行工具 → 写结果
wg.Wait()等待所有 goroutine 结束- engine 按下标遍历 results,封装成带 ToolCallID 的 user message 追加进 contextHistory
- 按下标顺序把 observationMsgs 聚合追加到 contextHistory,还原模型发出 ToolCalls 时的逻辑顺序
同路径读写锁(RWMutex)
为什么需要
大模型经过 RLHF 训练,正常情况都会发出能够并发的 ToolCalls 指令。这个功能主要是为了兜底大模型发出错误指令(如同路径同时读写)。
锁架构:全局锁 + 路径锁
类似大门锁 + 房门锁——拿到大门锁才能进去操作房门,同时也把 bash 执行和普通工具执行区分开来。
并行场景:同路径读读、分路径读写、分路径写写
串行场景:同路径读写、同路径写写、bash 和普通工具之间
执行流程
- 大模型在一轮中发起多个工具调用
- 判断 tool 是否定义了路径锁:
- 普通工具类:返回文件路径和锁类型
- bash 工具:直接全局锁独占整个工作区 + 执行
- 获取要锁的路径和锁类型后,将锁请求规范化:
- 同路径取等级最高的锁(W > R),防止重入 RWMutex 导致死锁
- 排序路径锁顺序,防止不同协程交叉上锁死锁
- 获取全局
RLock()锁——不阻塞其他协程获取 RLock(),但会阻塞 bash 获取全局 Lock(),实现普通工具和 bash 串行执行 - 根据第二步的返回,对路径锁进行操作
- 真正执行 tooluse
工具接口设计
定义工具基础有三个接口:Name()、Definition()、Execute(),每个工具都要实现这三个接口。
- Name():返回工具的名字
- Definition():使用 JSON 格式返回工具的 type 类型、properties 属性、required 需要的参数
- Execute():定义工具的执行逻辑。例如 read_file:拼接路径、IO 操作(打开、读取、关闭),需要注意截断
进阶:Bash 工具
原来的 bash 工具设计为启动、退出、日志三个功能集于一身,启动 server 时直接卡死。改造后拆分为:
Start()启动 server 后立即返回,stdout/stderr 重定向到.claw/run/<id>.log- 后续通过 bash 工具提供另外四个 action 进行管理
- 引入后台任务管理器(map + sync.Mutex)在下轮记住 PID、日志路径等状态
五个 action:
| Action | 功能 |
|---|---|
| run | 默认执行 |
| list | 列出任务 |
| status | 查状态 |
| logs | 看日志 |
| stop | 杀进程 |
踩坑:进程清理
刚写完程序测试了几遍,发现电脑变得很卡。排查后发现是进程没有清理干净——Agent 使用 bash 启动了一个服务,直接 kill 某个 PID 只会杀单个进程,启动的 server 还残留在后台。
解决方案:Setpgid: true 把子进程都归为一个进程组,再使用 kill -pid 杀整个进程组。
错误处理:IsError 机制的问题
当前设定了一个 IsError 字段,当工具调用失败时将 IsError 改为 true 并返回给模型,让模型自纠错。这种「完全依靠大模型盲目试错重试」的机制存在以下问题:
- 无限重试 / Token 爆炸:设置重试上限,超限后强制终止并返回错误
- 缺少结构化错误提示:当前只给出模糊的错误信息,模型只能靠猜
- 上下文污染:每次错误都被追加到 contextHistory,注意力被分散
- 模型可能绕过错误:模型可能通过其他路径绕过报错,而不真正解决问题
Session 隔离
当前使用的是简陋的直接截取滑动窗口的后几个 message。
需要注意大模型强制要求消息的连续性——不能出现单独的 toolResult,必须带有对应的 toolCall 信息。解决方案:直接舍弃孤儿工具响应,延顺下一条。
Working Memory 进阶策略
Token 感知截断(Token-aware Truncation)
系统不会简单按「条数」截取,而是实时计算每条历史消息的 Token 数量(通过 BPE 词表),从后往前塞入消息,直到总 Token 逼近模型安全水位线(比如 120k Tokens)时才停止。
摘要接力(Episodic Summarization)
当历史记录被截断时,引擎在后台触发一个小的廉价模型,将「被抛弃的旧记忆」浓缩成一段百字左右的大纲(Summary),并将其塞入 System Prompt 的头部。这样大模型既拥有了最新的细节记忆,又精简地保留了旧记忆。
上下文压缩最佳实践
- 短期记忆:维持一个动态的滑动窗口,存放最近 n 轮对话和 toolUse,这一层要绝对保真
- 中期记忆:当消息被挤出窗口时,使用 embedding 模型将其向量化,存入本地轻量级向量数据库,同时赋予 Agent 一个类似
search_memory的工具 - 持久化:不要指望大模型通过对话历史来记住当前的项目进度。最佳实践是在外部建立一个记忆文件,每次请求时注入到 System Prompt
- 工具设计要克制:引发上下文溢出的罪魁祸首往往是工具设计得不够克制。例如 read_file 需要有明确的 start_line、end_line;必须要读大文件时,在工具内部启动一个低阶模型子进程去提取摘要输出
上下文错误码进阶
传统框架中工具底层的 error 会被原样变成一段文本。大模型在无外力干预下看到工具报错,会遵循「最小阻力路径」。例如:试图使用 edit_file 替换一段代码,却因为幻觉写错了 old_text,导致匹配算法直接拦截报错,返回一串中文。在没有外力干预下,最小路径就是去猜一个新的 old_text,而不是使用 read_file 重新读一遍。
解决方法:代码在报错时返回一个 POSIX 错误码(在 macOS、Linux 上都很稳定),再根据 err 返回的错误码进行匹配,将对应的解决方法添加到上下文中返回给大模型。这样大模型就知道具体报错是什么了,而不是一串模糊的文本。